


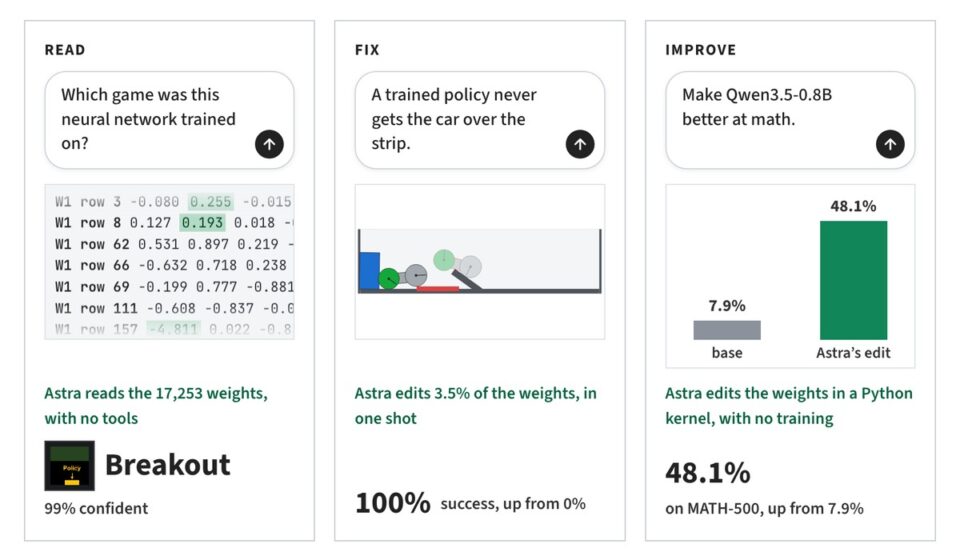

2026 年 11 月 2 日,MIT CSAIL 的 Rikiya Takehi、Jayden Teoh、Alex Zhang 與 Omar Khattab 發表一項名為「Weight-Space Programming」的實驗,隨即在 Hacker News 累積兩千多分。華語圈流傳的版本是「GPT-6 Astra 被移植了 Qwen 的權重,數學由 7.9% 升到 48.1%」。方向剛好相反:Astra 是編輯者,Qwen3.5-0.8B 才是被編輯的模型,整個過程沒有一個權重被搬進 Astra。
誰動手、誰被改:兩個角色不能對調
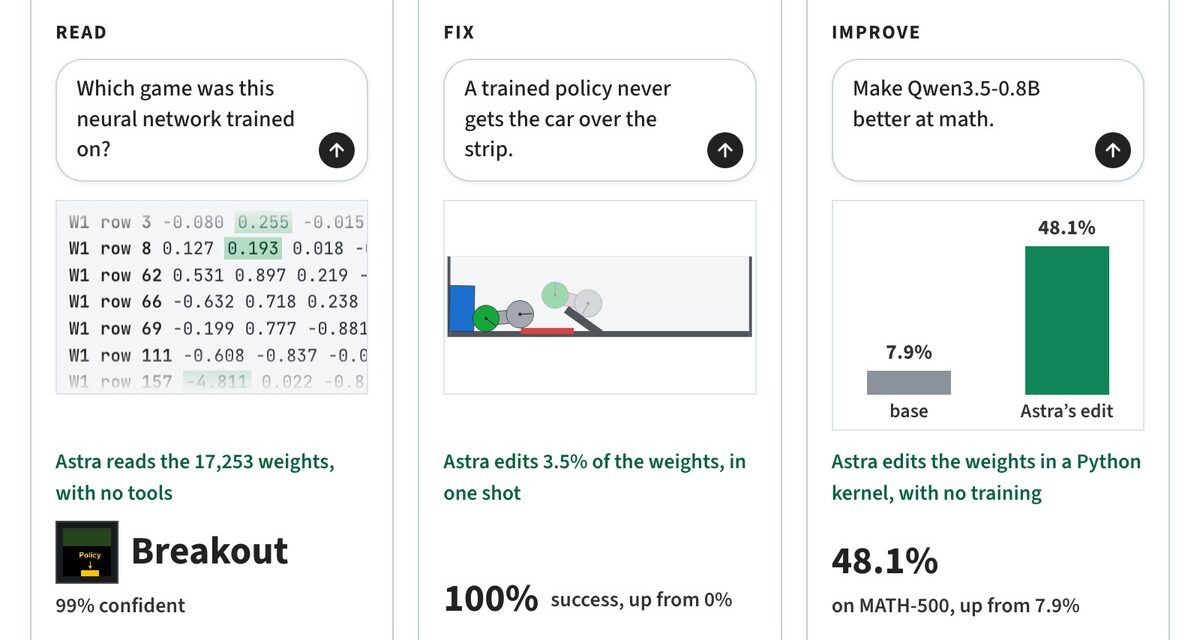
實際流程是這樣:Astra 透過 OpenAI 的 Codex CLI 運作,推理強度設為 max,在一個只跑 CPU、沒有 GPU、沒有上網的 Python kernel 裡,直接讀寫 Qwen/Qwen3.5-0.8B 這個公開權重檔。它可以呼叫前向傳遞工具(預算 10、25 或 50 次),每次最多跑 512 條練習題,或做 256 對 256 的原版/修改版對照。Astra 在 MATH 與 GSM8K 的 train 分割上練習,測試集從未給它看過。
規則寫得很硬:不准梯度下降、不准 backward pass、不准優化器、不准把模型跑在 kernel 內、不准上網。save_edit 會拒絕改動 final norm、embedding 與輸出層,也拒絕「整張張量乘一個常數」這種假編輯。所以這不是微調、不是 LoRA、不是激活替換,也不是模型合併——是由一個前沿模型算出座標,再對別人的權重做手術。
改了多少:131,072 個權重,佔 0.0164%
最後提交的編輯只動兩張張量:第 15 與第 19 層 MLP 的 down_proj。公式是 W = W0 − 6 × outer(u, mask64 × (u @ W0)),其中 u 是從四組配對語境推導出的單位「重複方向」,mask64 選出每層 64 個 MLP 輸出神經元。總共改變 131,072 個數值,以 8 億參數計是 0.0164%。這個數字是真的,也是已發布 checkpoint 的 bit-exact diff,可用 sha256 對照。
但 0.0164% 不等於影響很小:局部位移 10.64% 與 8.11%
把比例讀成「幾乎沒改」是這類報導最常見的另一個錯。被動到的兩張矩陣,相對變化分別是第 15 層 10.64%、第 19 層 8.11%。0.0164% 是分母很大的算法;在那兩層裡,各有六十四個 MLP 輸出神經元所帶的方向被整條減掉。作者自己的比喻是「像刪掉模型權重裡的某一個方向」,而不是在表面塗一層。

真正的病灶是迴圈,不是不會算
基礎模型在 MATH-500 的 7.9%,大部分不是算錯,而是話說不完。它的答案有 93.0% 撞上 32,768 token 上限被截斷,被截的尾巴有 95.8% 是重複的 8-gram;頭 96 條練習答案裡有 85 條直接跑到上限。Qwen 自己的 model card 也寫明,0.8B 版「比其他 Qwen3.5 更容易進入 thinking loop」。Astra 找到的是那條被第 15、19 層 MLP 寫出來的方向,把它減掉。
編輯後,撞上限的比例由 93.0% 降到 33.1%,MATH-500 則由 7.9% 升到 48.1%。這兩個數字要一起看:分數跳升主要來自「終於講得完」,而不是突然會解難題。旁證是 IFEval 由 21.0% 升到 62.3%,一個與數學無關的指令遵循測試,漲幅卻差不多。
為什麼不能說「他們教會了 Qwen 數學」
作者自己否認這個說法。他們的句子是:這個編輯「讓模型把它本來就算得出來的答案講完」,而編輯「可以移除擋住能力的障礙,但不能加入模型沒有的能力」。最有力的證據是控制組:Gemma 3 270M 本來就很少迴圈(只有 8.5% 的答案觸及 token 上限),Astra 找不到單一的罪魁方向,五十次前向傳遞後 MATH-500 由 6.8% 只走到 7.0%,二十五次時最高 7.7%,每次改動的幅度都沒有超過約 1 個百分點。
劑量測試也支持同一讀法:目標重複方向的 logprob 在 alpha 1/2/4 時下降 0.0241/0.0487/0.1037 nats/token,而有效分支幾乎不動;只改第 15 層或只改第 19 層都有效;方向隨機但範數相同的對照組只賺 1.56 個百分點(SE 3.52)。
7.9% 與 48.1% 之外,還有幾組必須一起讀的數字
同一份結果裡,GSM8K 由 13.8% 升到 67.1%,AMC23 由 0.5% 升到 23.4%,Minerva Math 1.5% 到 25.4%,OlympiadBench 1.3% 到 21.8%,MMLU-Pro 40.3% 到 45.5%,GPQA Diamond 22.7% 到 36.6%。作者另做了一次留出練習題的確認:1,152 條未參與編輯的問題,10.6% 升到 60.4%,579 條被救回、5 條變差。
限制也要寫在同一段:頭條只在 50 次前向傳遞那一跑成立,10 次與 25 次分別只有 12.3% 與 14.1%;50 次、每次最多 512 條,等於最多約 25,600 條已批改的練習回饋,「沒有梯度」是真的,「沒有任務資訊」不是。作者自己的 Hugging Face 卡重跑得到 51.0%(撞上限比例 31.6%),方向一致但高大約 3 個百分點,第三方複現仍從缺。加上 MATH-500 是公開 benchmark、可能已在預訓練資料裡,作者沒有做污染檢查。母體是 0.8B 的單一模型,每個預算只跑一次。
OpenAI 沒有回應,動機之說沒有證據
Hacker News 上最熱的猜測是「OpenAI 是不是專門把 Astra 訓練成會讀權重」。目前沒有證據支持:原始部落格、公開 log repo、VentureBeat 的報導與 HN 討論串裡,都找不到 OpenAI 的任何聲明、承認、資助或合作說明。可以確認的只有 Astra 是透過 Codex CLI 呼叫的專有 API 模型,它那一半無法被外人完整複現;能被複現的是 Qwen 這一半,因為權重與 diff 都公開了。
常見問題
Astra 有變得比較會算數學嗎?
沒有。Astra 全程是編輯工具,被評估的一直是 Qwen3.5-0.8B。任何「Astra 數學進步六倍」的標題都把主語弄錯了。
0.0164% 是否代表改動微不足道?
不代表。那是全模型比例;實際被改的兩張 down_proj 矩陣,相對位移是 10.64% 與 8.11%,且集中在六十四個輸出方向上。
這是微調或激活替換嗎?
都不是。沒有梯度、沒有 backward pass、沒有優化器,也不是在推論時干預激活,而是直接改 checkpoint 裡的數值。
這段結果可以推廣到更大的模型嗎?
未證實。0.8B 是目前被編輯過最大的模型,成效依賴目標存在單一主導的迴圈方向;Gemma 控制組正好說明,沒有這個前提就沒有這種跳升。
把方向、機制與數字分開之後,這項工作的形狀其實很清楚:一個前沿模型讀得懂別人的權重,找到一條製造迴圈的方向,減掉它,於是一個本來會說話說到斷氣的模型,終於把答案講完。剩下的問題不是它有多神,而是這套方法在沒有單一罪魁方向、或更大的模型上,還剩多少——你覺得下一次會被這樣「動手術」的,會是哪一種能力?
分類:AI
標籤:GPT-6 Astra · Qwen3.5-0.8B · 權重編輯 · MATH-500 · 思考迴圈 · MIT CSAIL
